语音播报
语音播报会朗读弹幕、礼物和醒目留言,无需持续关注屏幕即可了解直播间动态。
| 界面 | 入口 |
|---|---|
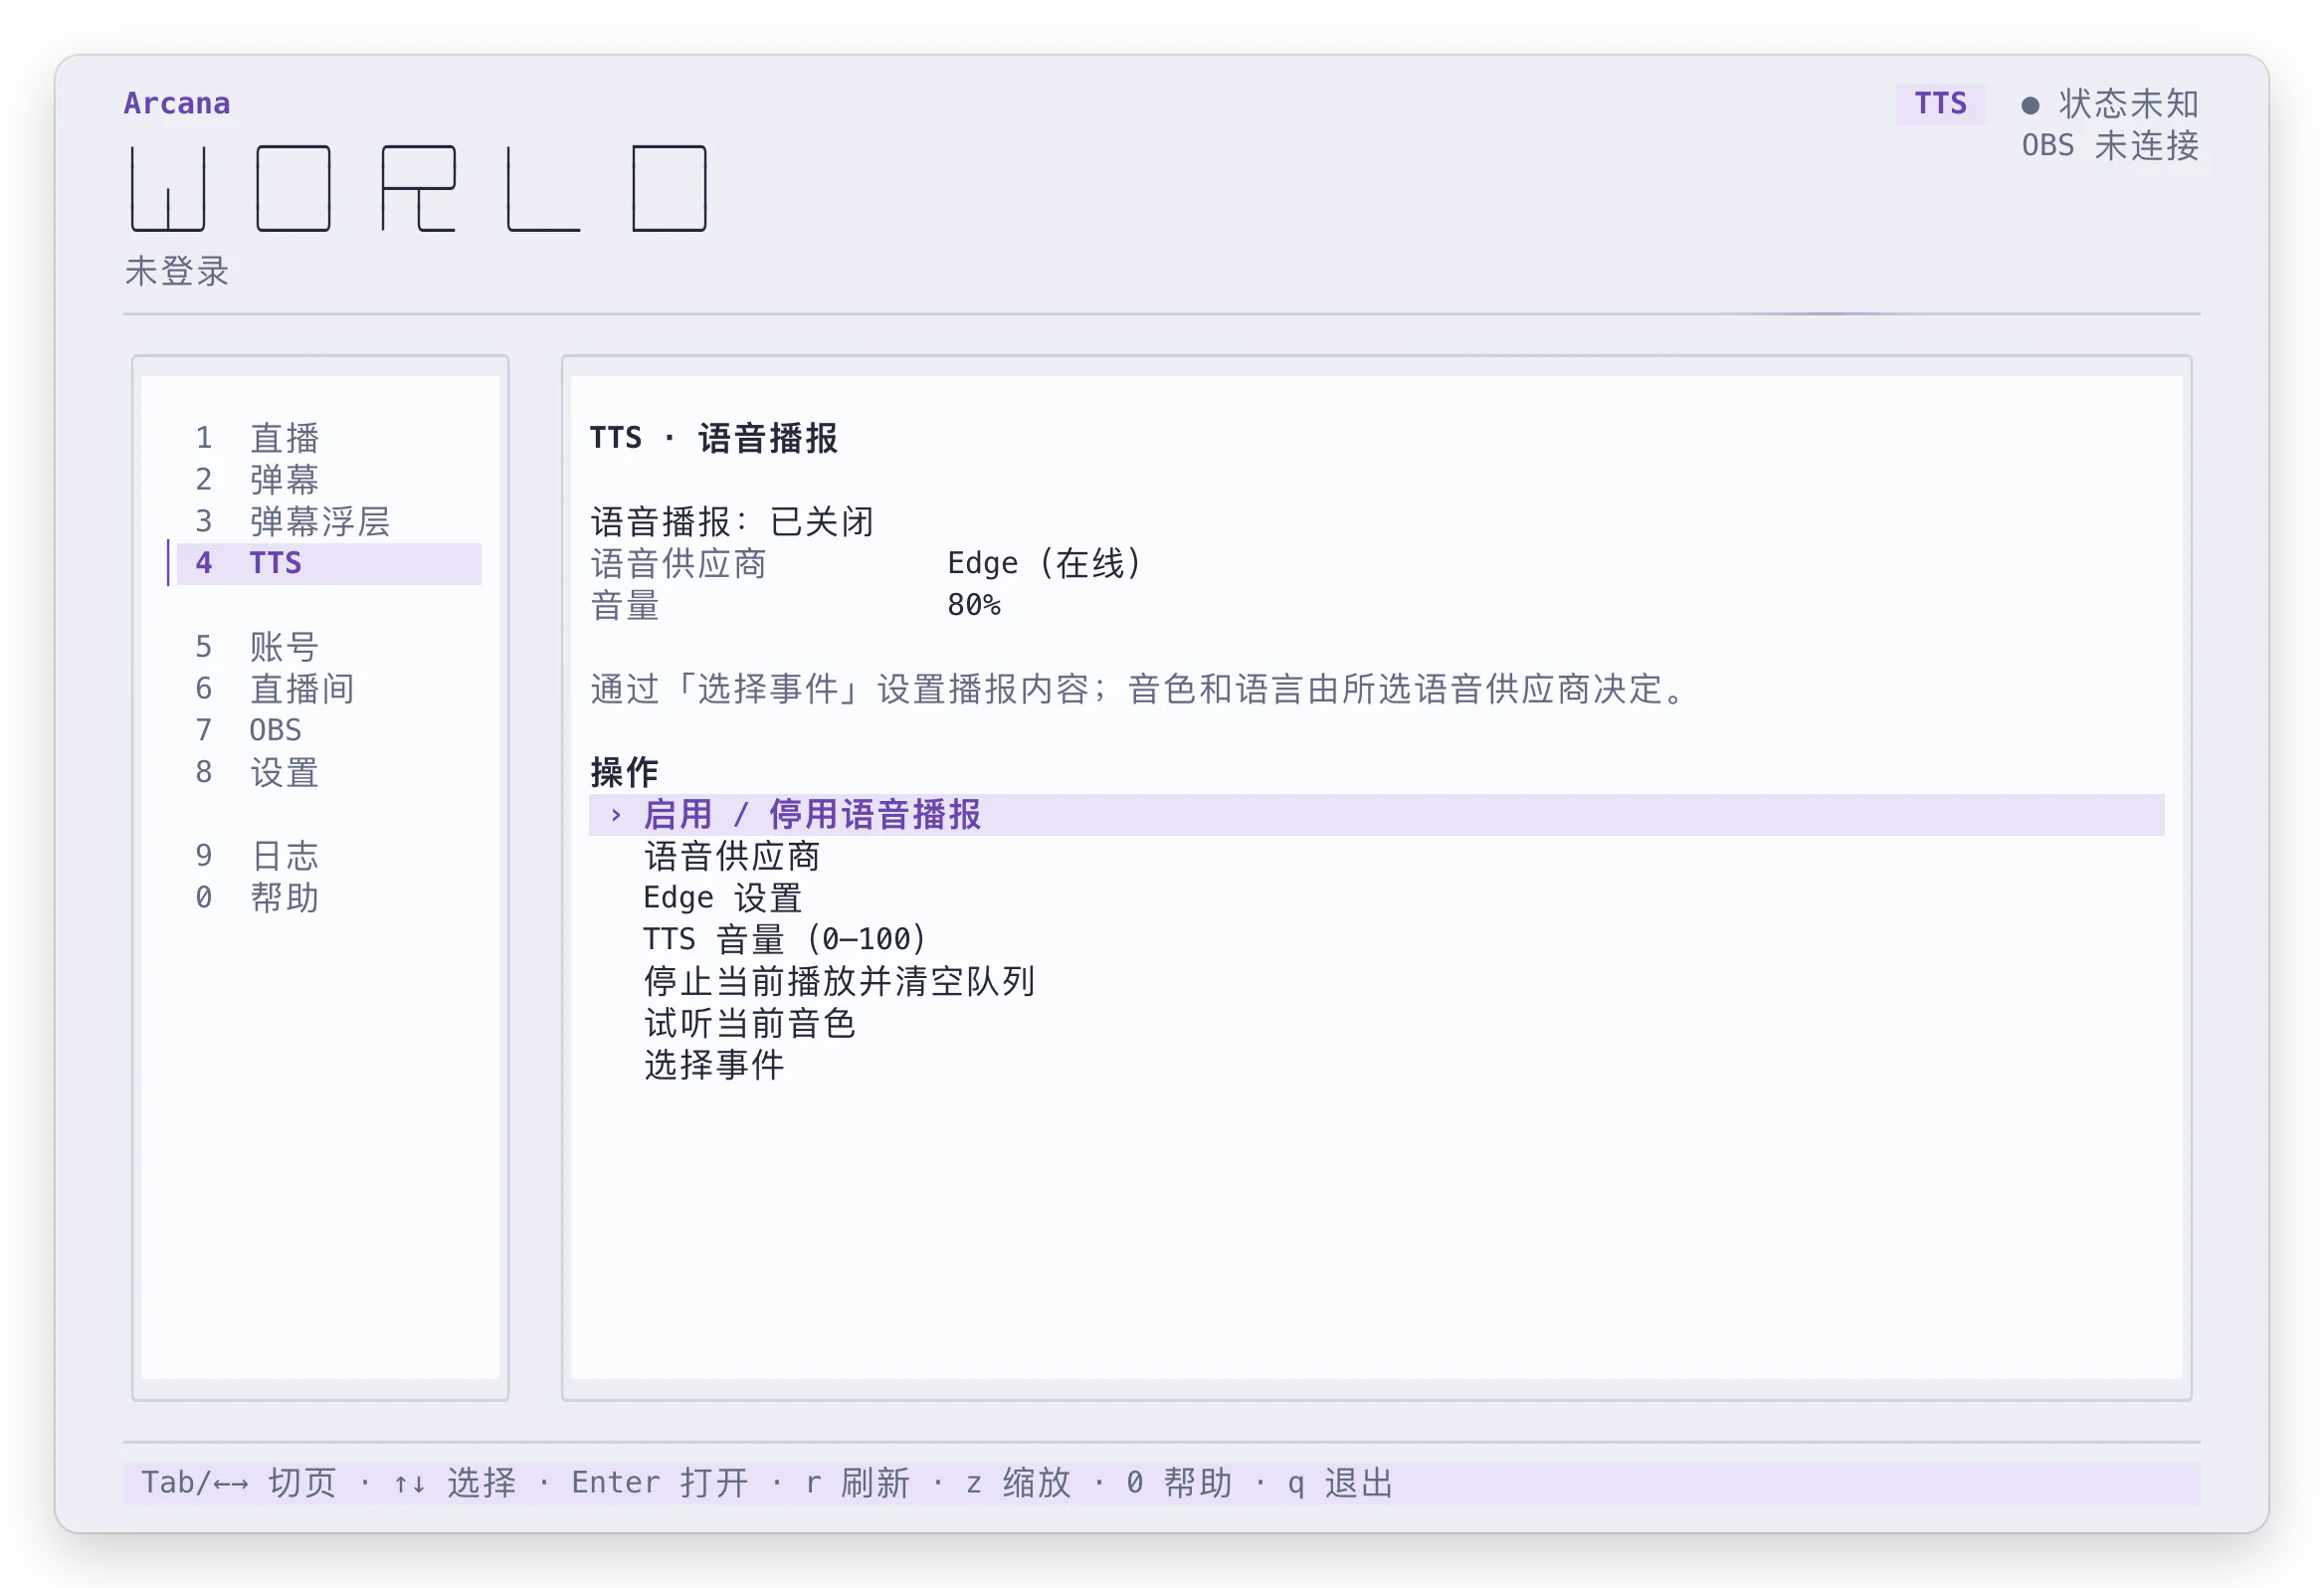
| 终端界面 | 按 4 打开「TTS」页 |
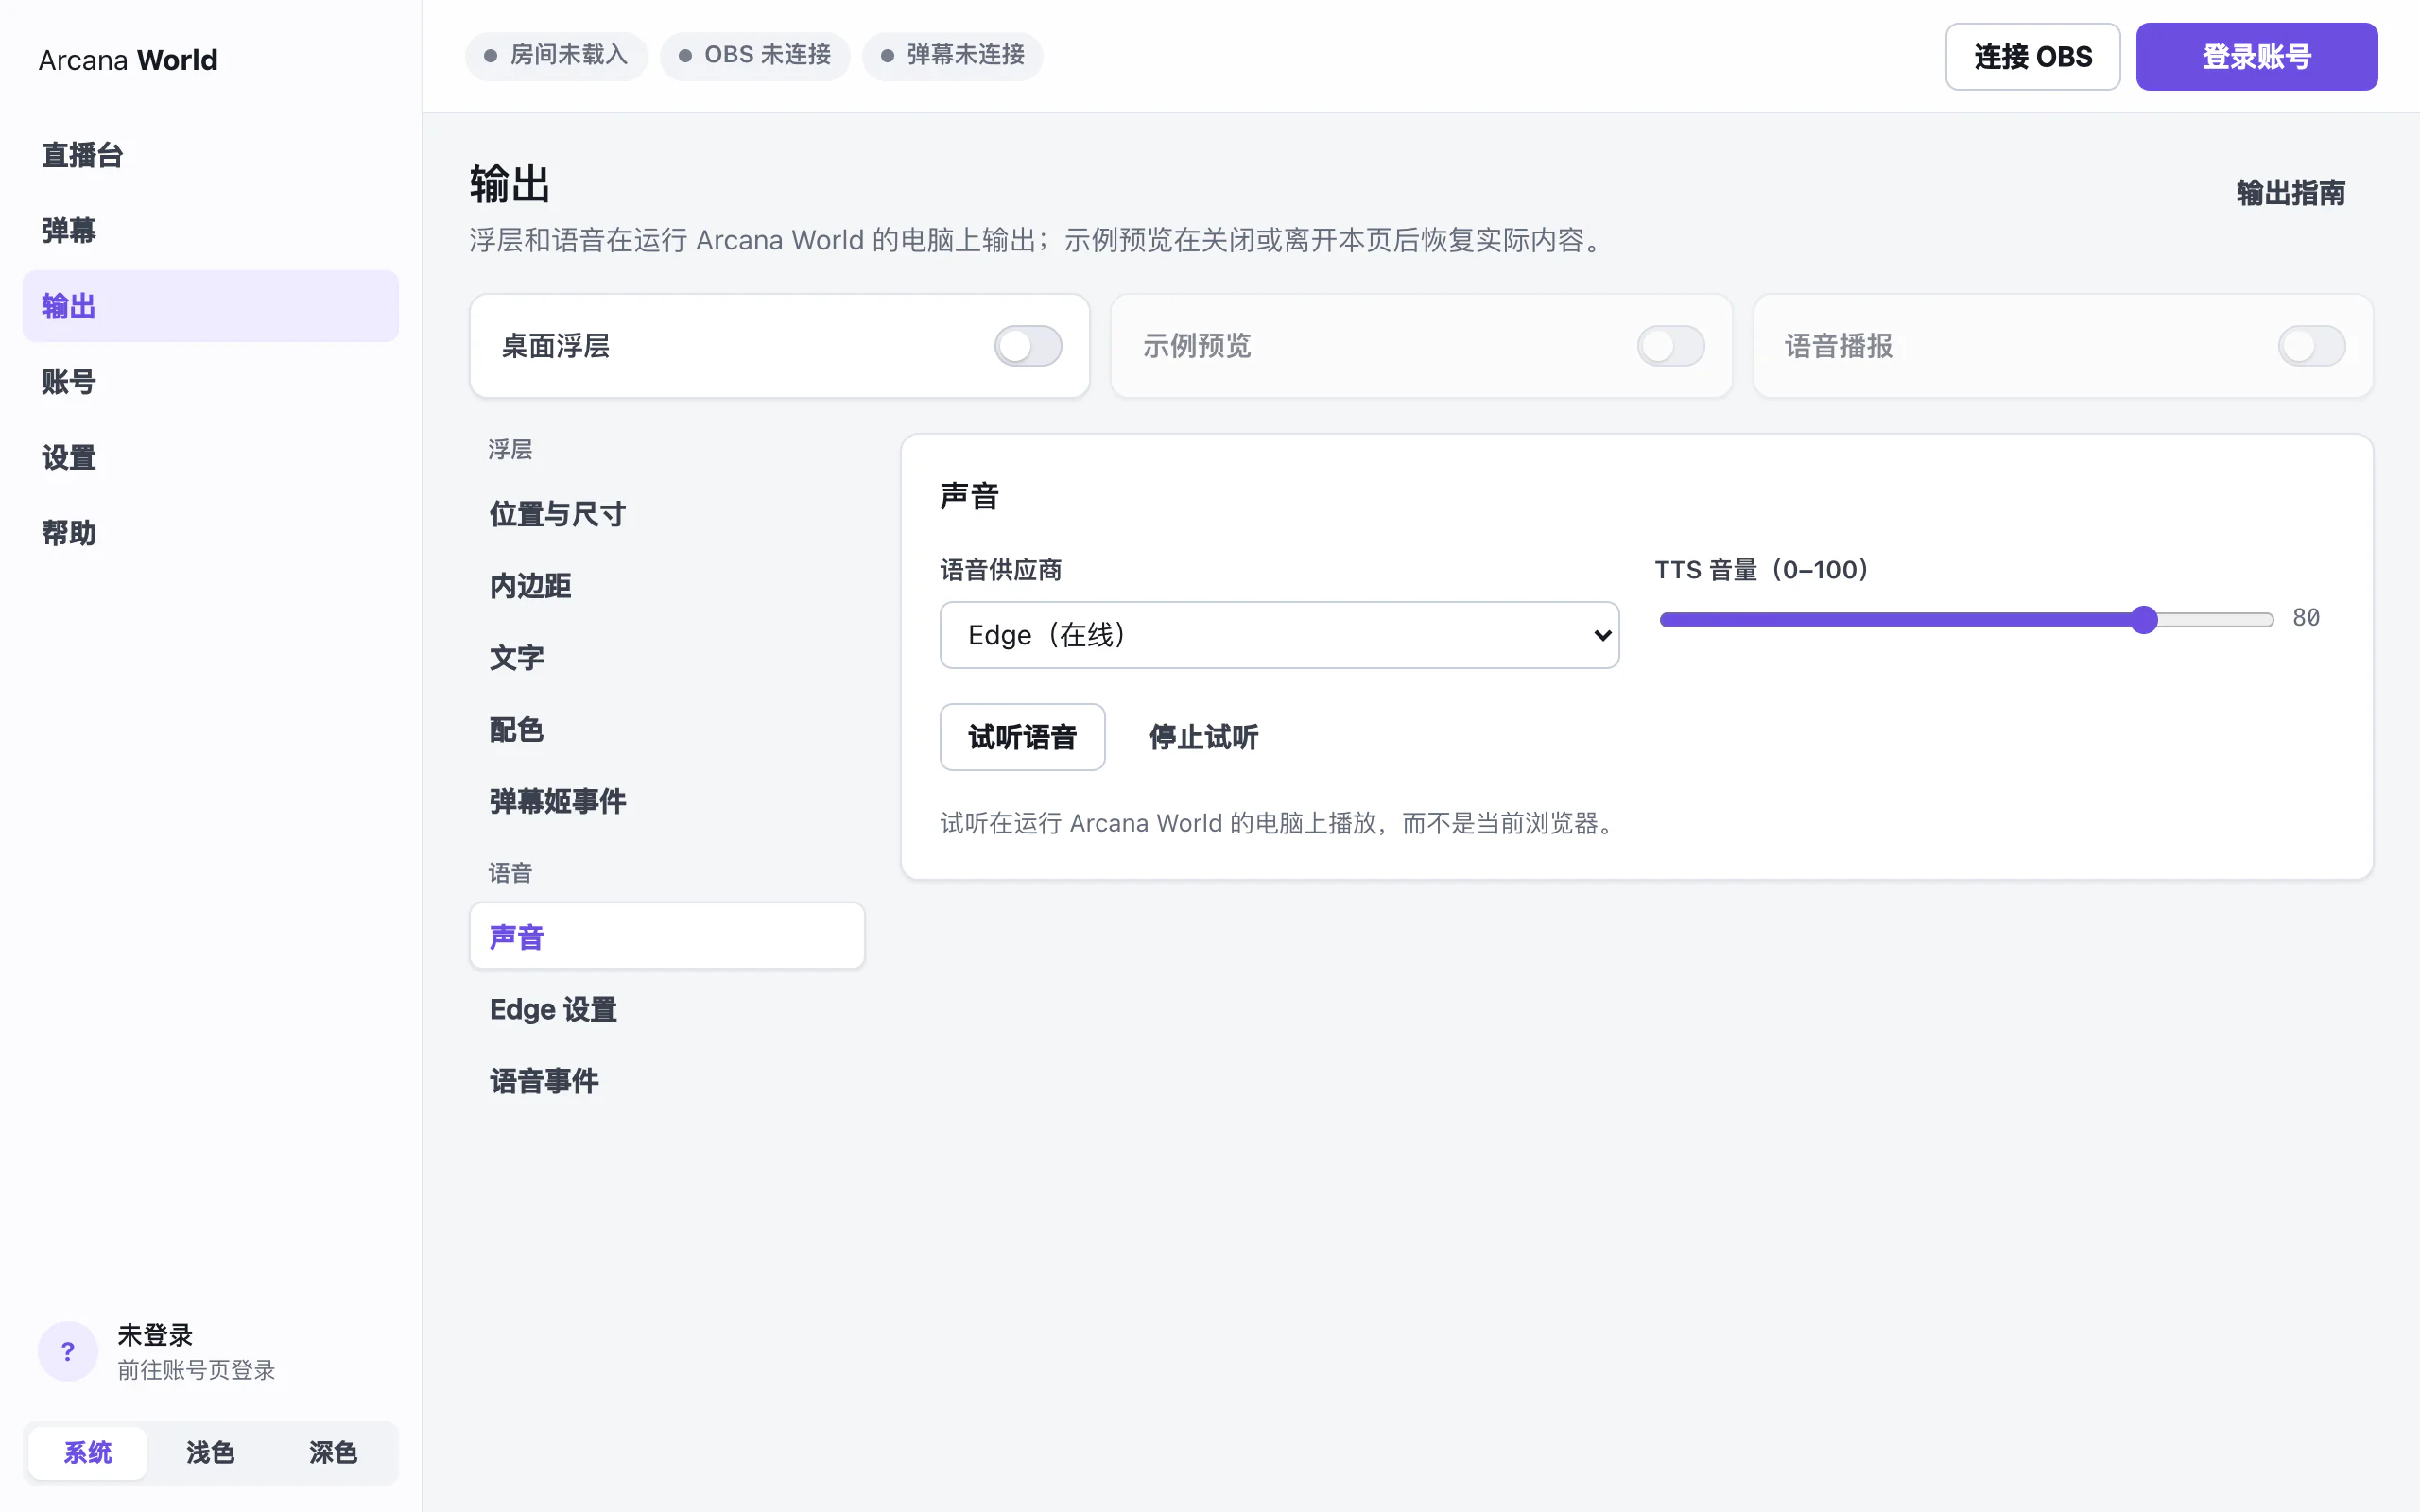
| 网页面板 | 打开「输出」→「声音」 |
声音从运行 Arcana World 的电脑播放,通过网页面板操作时同样如此,浏览器不会发声。下文使用终端界面的名称。
1. 选择语音
在「语音供应商」中选择一种:
| 语音 | 特点 | 准备条件 |
|---|---|---|
| Edge(默认) | 免费,无需注册,10 种中文音色,偶尔暂时无法连接 | 联网 |
| 千问 | 付费云端语音,稳定 | 阿里云百炼 API Key |
| 豆包 | 付费云端语音,稳定,音色多 | 火山引擎 API Key |
| MeloTTS | 本地,中英双语,一个女声 | 下载约 164 MB 模型 |
| Kokoro v1.1 | 本地,中英双语,103 个音色 | 下载约 365 MB 模型 |
| Piper | 本地,仅英语 | 下载约 67 MB 模型 |
推荐默认使用 Edge,无需配置。本地语音无需联网,但合成时占用 CPU/GPU,游戏直播时注意性能开销。
每种语音的设置单独保存,切换语音后无需重新填写。
2. 配置
打开对应的设置(如「Edge 设置」「千问 TTS 设置」):
- Edge:在「TTS 音色」中选择音色,默认为晓晓(普通话女声)。
- 千问、豆包:填写 API Key,见下文。
- MeloTTS、Kokoro、Piper:安装模型,见下文。
音量在「TTS 音量(0–100)」中调节,默认 80。
千问和豆包
- 千问:在阿里云百炼开通语音合成并创建 API Key,填入「千问 TTS 设置」的「API Key」。默认地址对应中国内地,国际站账号需将「Base URL」改为所在地域的地址。
- 豆包:在火山引擎开通语音合成并获取 API Key,填入「豆包 TTS 设置」的「API Key」。默认音色为 Vivi 2.0;更换音色时,在「资源 ID」和「TTS 音色」中填写账号已开通的资源 ID 和音色 ID。
API Key 保存后不再显示,如需更换,直接重新填写。
安装本地模型
- 在「语音供应商」中选择 MeloTTS、Kokoro v1.1 或 Piper。首次选择未安装的模型时,会提示是否立即下载。
- 选择下载(或稍后在设置中点击「安装模型」)。
- 等待下载、校验和解压完成,设置中显示「模型已安装」即安装成功。
下载可中途取消,下次从断点继续。模型存放在主程序旁的 models/tts/ 文件夹,因此整套程序需放在可写入的位置。
本地语音默认使用显卡合成。提示 GPU 语音合成失败时,更新显卡驱动,或将「运行设备」改为「CPU」。
应用内下载过慢:手动安装模型
手动下载模型包:
| 模型 | 下载 | 模型文件夹(在 models/tts/ 里) |
|---|---|---|
| MeloTTS | ZIP | melo-zh-en/ |
| Kokoro v1.1 | tar.bz2 | kokoro-multi-lang-v1_1/ |
| Piper | tar.bz2 | vits-piper-en_US-ljspeech-medium/ |
然后任选一种方式:
- 将压缩包放到设置中「手动安装压缩包」显示的路径,点击「安装模型」。
- 将压缩包内的文件解压到「模型目录」显示的文件夹(不要多嵌套一层目录),点击「校验模型」。
3. 试听
选择「试听当前音色」(网页面板为「试听语音」),电脑会朗读一句示例。没有声音时,检查该电脑的输出设备、系统音量和「TTS 音量」。
4. 选择播报事件
在「选择事件」中勾选需要朗读的内容,例如弹幕较多时仅播报礼物和醒目留言。此处的选择与弹幕浮层互不影响。
如需修改播报措辞,参见自定义浮层与播报文字。
5. 启用播报
选择「启用 / 停用语音播报」(网页面板在「输出」页顶部打开「语音播报」开关)。页面显示「语音播报:等待新事件」后,新收到的事件会依次朗读。启用前的旧弹幕不会补读。
播报直播间事件需要开启弹幕监听,参见弹幕与观众管理。
选择「停止当前播放并清空队列」可立即停止正在朗读的内容;如需长期停止,关闭语音播报。
常见问题
| 现象 | 处理方法 |
|---|---|
| 试听正常,直播时不播报 | 检查播报开关、弹幕监听和事件选择;状态显示「等待监听」表示弹幕监听未开启 |
| 提示 API Key 不正确或未开通 | 重新填写 API Key,确认账号已开通语音合成和所选音色 |
| 提示无法连接 | 检查网络和代理;千问、豆包还需检查「Base URL」 |
| Edge 暂时拒绝了请求 | 稍后重试,或更换语音 |
| 模型下载失败 | 重试,或手动安装 |
| 提示文件夹无法写入 | 将整套程序移到可写入的位置后再安装模型 |
| 提示找不到语音组件 | 重新完整解压发行包,保留 libexec 文件夹 |
更多排查方法参见常见问题。
其他细节
- 在线语音(Edge、千问、豆包)使用「设置」中的网络代理,代理须为 http 或 socks5。
- 「恢复默认设置」保留 API Key,「清除应用数据」会删除 API Key;两者均不删除本地模型。
- 事件过快时最多排队 5 条,超出的事件会被跳过,「TTS」页显示「队满跳过」的数量。
- 本地语音还可调节「CPU 线程数」(默认 4)和「语速」(默认 1)。Linux 使用显卡合成需要支持 Vulkan 的显卡驱动;macOS 需要 Apple 芯片和 macOS 14 及以上版本。
- 启动时添加
-tts或-tts=false仅对本次运行生效,参见命令行参数。